CNN-Objekterkennung: die Herzregion in Mikroskopvideos
In meiner Bachelorarbeit habe ich einen Objektdetektor darauf trainiert, die Herzregion in Mikroskopvideos von Medaka-Embryonen zu finden, einem kleinen Fisch aus der biologischen Forschung. Der Detektor ist für einzelne Farbfotos gebaut, ein Herz zeigt sich aber nur als Bewegung über die Zeit. Die meiste Arbeit steckte darin, zu ändern, was das Modell sieht.
- Rolle
- Bachelorarbeit, alleiniger Autor
- Wo
- Universität Heidelberg, mit dem Centre for Organismal Studies
- Ergebnis
- mAP@0.5 0,86, Precision 0,93, Recall 0,84
- Grenzen
- Rund 100 Videos; Validierungswerte
Abbildungen und Einzelbilder stammen aus der Arbeit (Januar 2023, Note 1,0, nicht veröffentlicht). Die Embryo-Aufnahmen stammen von der beteiligten Forschungsgruppe.
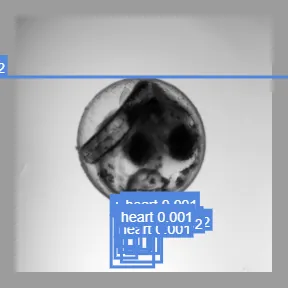
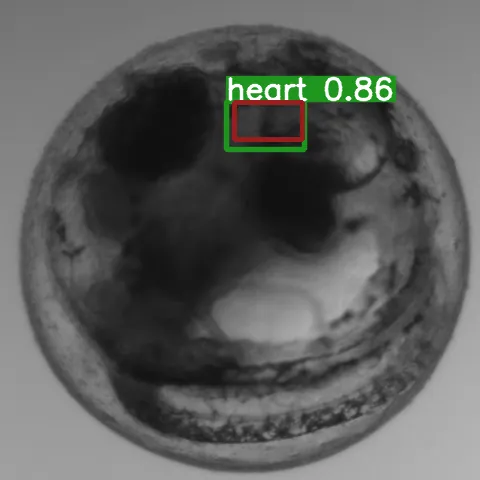
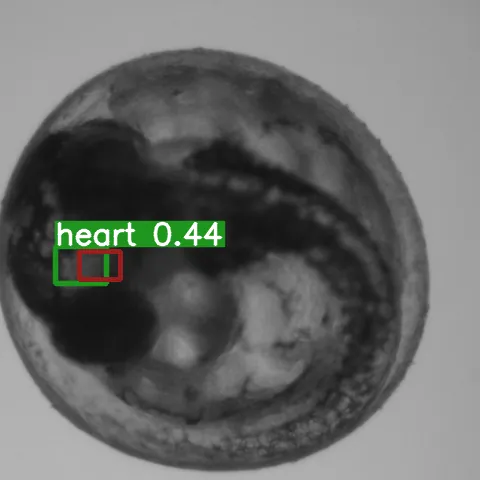
Detektionen in Stufe 2 und Stufe 10
Problem: ein Herz erkennt man nur an der Bewegung
Die Herzfrequenz ist das wichtigste Signal dafür, wie diese Embryonen auf Stress und andere Reize reagieren. Die Forschungsgruppe fand das Herz mit einer Frequenzanalyse und maß den Schlag mit einer zweiten. Meine Arbeit ersetzt den ersten Schritt durch ein neuronales Netz, YOLOv5.
In einem Einzelbild sieht das Herz aus wie das Gewebe drumherum. Erkennbar ist es, weil es sich bewegt: Ein Schlag dauert 14 bis 15 Bilder. YOLOv5 erwartet ein Farbbild. Der Datensatz umfasste rund 100 Videos mit je 240 Bildern, etwa ein Fünftel davon schwierige Fälle mit undurchsichtigen Embryonen oder verdeckten Herzen.
Verworfen: vortrainierte Gewichte, starke Augmentation, CLAHE
- Vortrainierte Gewichte: mAP@0.5 von 0,015 mit drei Graustufenbildern, schlechter mit 20 Kanälen (rund 90 Prozent kamen aus den ersten drei). Erst das Training von Grund auf brachte einen Lerneffekt.
- Viel Augmentation schadete (alle Videos unter denselben Bedingungen aufgenommen); geholfen haben nur Skalieren und Spiegeln.
- Kontrastverstärkung machte einzelne dunkle Fälle sichtbar und senkte alle anderen Werte.
Ansatz: Delta-Frames statt RGB
Bewegung statt Farbe. Statt des RGB-Bilds bekam das Netz 20 Graustufenbilder, dann Delta-Frames zwischen den Bildern; laut Arbeit der wichtigste Schritt. Der Vergleich jedes Bilds mit einem Basisbild machte zusätzlich schwache Bewegungen sichtbar, die Differenzen von Bild zu Bild übersahen. Stufe 10 nahm das letzte Bild selbst dazu.
Der Zuschnitt der Videos von 900 auf 480 Pixel senkte die Trainingszeit je Epoche von 360 auf 6 Sekunden. Erst das machte die vielen kleinen Versuche möglich.
Delta-Frames: Basisbild gegen Bild zu Bild
-
Stufe 4: Von Grund auf trainiert
Vortrainierte Gewichte ließen sich nicht übertragen: Mit drei Graustufenbildern erreichte der vortrainierte Detektor ein mAP@0.5 von 0,015 (Stufe 2). Erst das Training von Grund auf brachte einen Lerneffekt, 0,10 in allen drei Werten.
-
Stufe 5: Skalieren und Spiegeln
Viel Augmentation schadete, weil alle Videos unter denselben Bedingungen entstanden. Nur Skalieren und Spiegeln halfen: Precision und Recall steigen auf 0,30.
-
Stufe 6: Delta-Frames
Bewegung statt Farbe. Das Netz bekommt Differenzen zwischen Bildern statt der Bilder selbst. Laut Arbeit der wichtigste Schritt: mAP@0.5 steigt von 0,15 auf 0,77.
-
Stufe 9: Basisbild-Methode
Jedes Bild mit einem Basisbild zu vergleichen statt mit dem vorherigen, machte schwache Bewegungen sichtbar. Alle drei Werte erreichen 0,84 oder mehr.
-
Stufe 10: Dazu das letzte Bild
Stufe 10 nimmt das letzte Bild selbst dazu. Die Precision steigt auf 0,93, der Recall bleibt bei 0,84, das mAP@0.5 bei 0,86. Das ist das Ergebnis der Arbeit, auf den Validierungsdaten.
Versuchsübersicht: 11 Stufen, 3 Seitenzweige
- Stufe 1 pretrained 1× RGB
- Stufe 2 pretrained 3× grayscale
- Stufe 3 pretrained 20× grayscale
- Stufe 4 scratch 20× grayscale
- Stufe 5 scratch + augment
- Stufe 6 scratch + diff-maps
- Seitenzweig 6.1 + rebalanced dataset
- Stufe 7 scratch + cos-lr
- Stufe 8 scratch + keep-base
- Seitenzweig 8.1 + AHE
- Seitenzweig 8.2 + CLAHE
- Stufe 9 scratch + new diff-maps
- Stufe 10 scratch + keep-last-and-base
- Stufe 11 scratch 20× + 20× grayscale
Unterwegs abgestimmt: Batch-Größe, Modell, Kanäle, Loss, Augmentation, Optimizer, NMS, Bildgröße.
Nachgezeichnet nach Abbildung 12 der Arbeit. Jede Stufe behält die Änderungen der vorigen; die Farben folgen der Bewertung im Original, von Rot bis Dunkelgrün.
Grenzen
- Vollständig verdeckte Herzen werden nur teilweise gefunden; schwierige Fälle haben eine niedrige Konfidenz.
- Kleiner Datensatz, die Werte sind statistisch nur eingeschränkt belastbar; alle stammen aus den Validierungsdaten.
- Die Arbeit findet die Herzregion; ob das für die Messung der Herzfrequenz reicht, blieb offen.
- 3,96 Sekunden je Video auf einer Workstation-GPU, 28,6 Sekunden auf 12 CPU-Kernen: langsamer als angestrebt.
Werkzeuge: Python, PyTorch, YOLOv5